KI & Banking
KI und Decision Engine: Predictions in der Mitte des Kreislaufs, nicht am Ende
Teil 3/5: Prognosen sind Eingaben, nicht Ergebnisse. Was im Entscheidungsdatensatz steht, welche vier Entscheidungsarten es gibt und was das LLM nicht tut.
•
acceleraid Redaktion
•
5 Min. Lesezeit
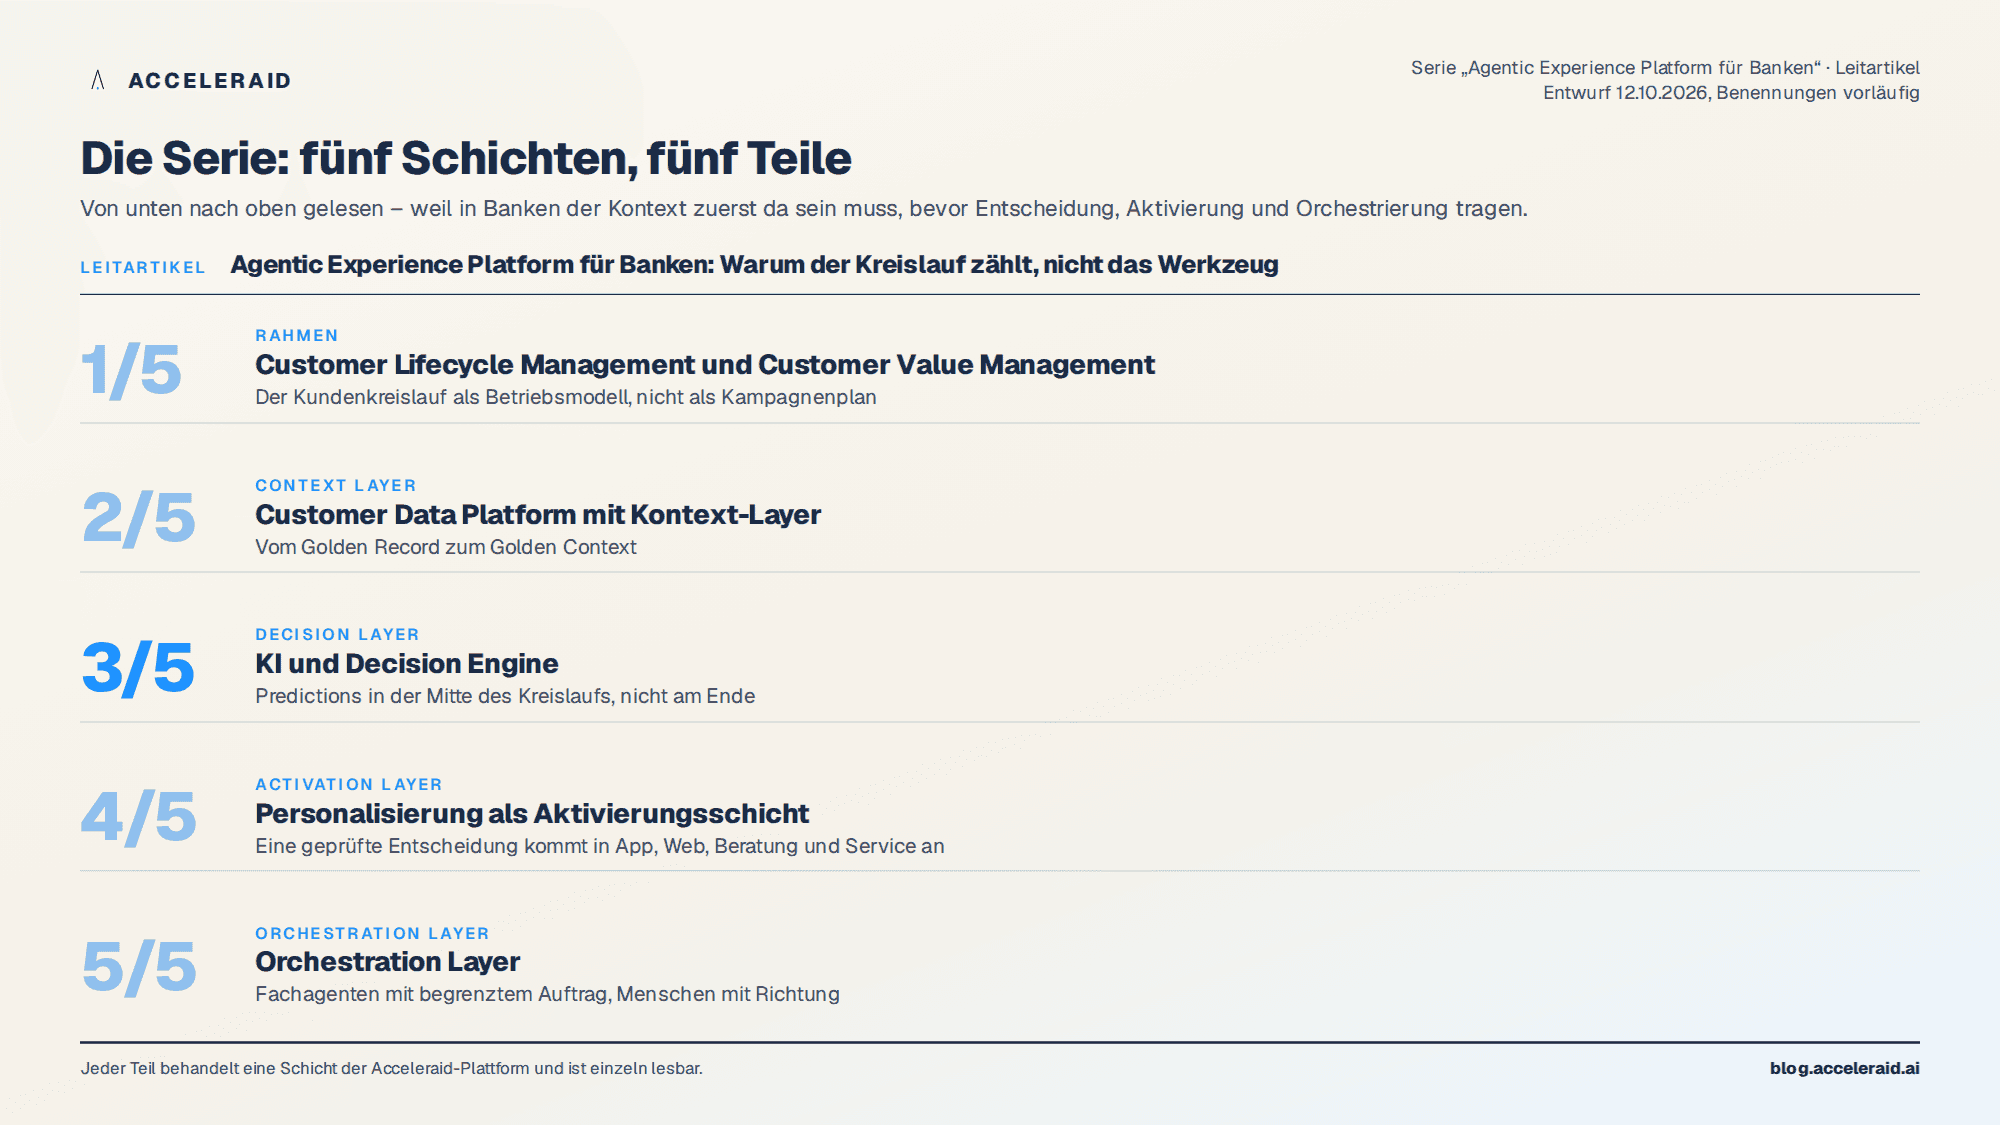
Serie Agentic Experience Platform für Banken · Teil 3 von 5. Der Leitartikel beschreibt die fünf Schichten, Teil 2 den Kontext-Layer. Dieser Teil geht in die Mitte des Kreislaufs: die Decision Engine.
In vielen Darstellungen von KI im Banking steht die Prognose am Ende: Ein Modell berechnet eine Abwanderungswahrscheinlichkeit, und die Kampagne reagiert darauf. In einer Agentic Experience Platform steht die Prognose in der Mitte. Sie ist eine Eingabe der Entscheidung, nicht ihr Ergebnis. Zwischen dem Score und der Handlung liegen Regeln, Ziele, Grenzen und ein Datensatz, der festhält, warum etwas entschieden wurde. Dieser Teil beschreibt, was diese Schicht leistet und warum das Sprachmodell darin eine Nebenrolle hat.
Was in die Entscheidung hineingeht
Die Entscheidungsschicht der Acceleraid-Plattform erhält aus dem Schritt Verstehen fünf Arten von Eingaben: Abwanderungsrisiko, Produktaffinität, Kontaktbereitschaft, Risiko- und Betrugssignale sowie die Zugehörigkeit zu einem Cluster ähnlicher Situationen. Keine dieser Eingaben ist eine Entscheidung. Ein hohes Abwanderungsrisiko sagt nicht, ob ein Anruf, ein Angebot oder bewusste Stille die richtige Antwort ist. Es sagt nur, dass der Fall Aufmerksamkeit verdient.
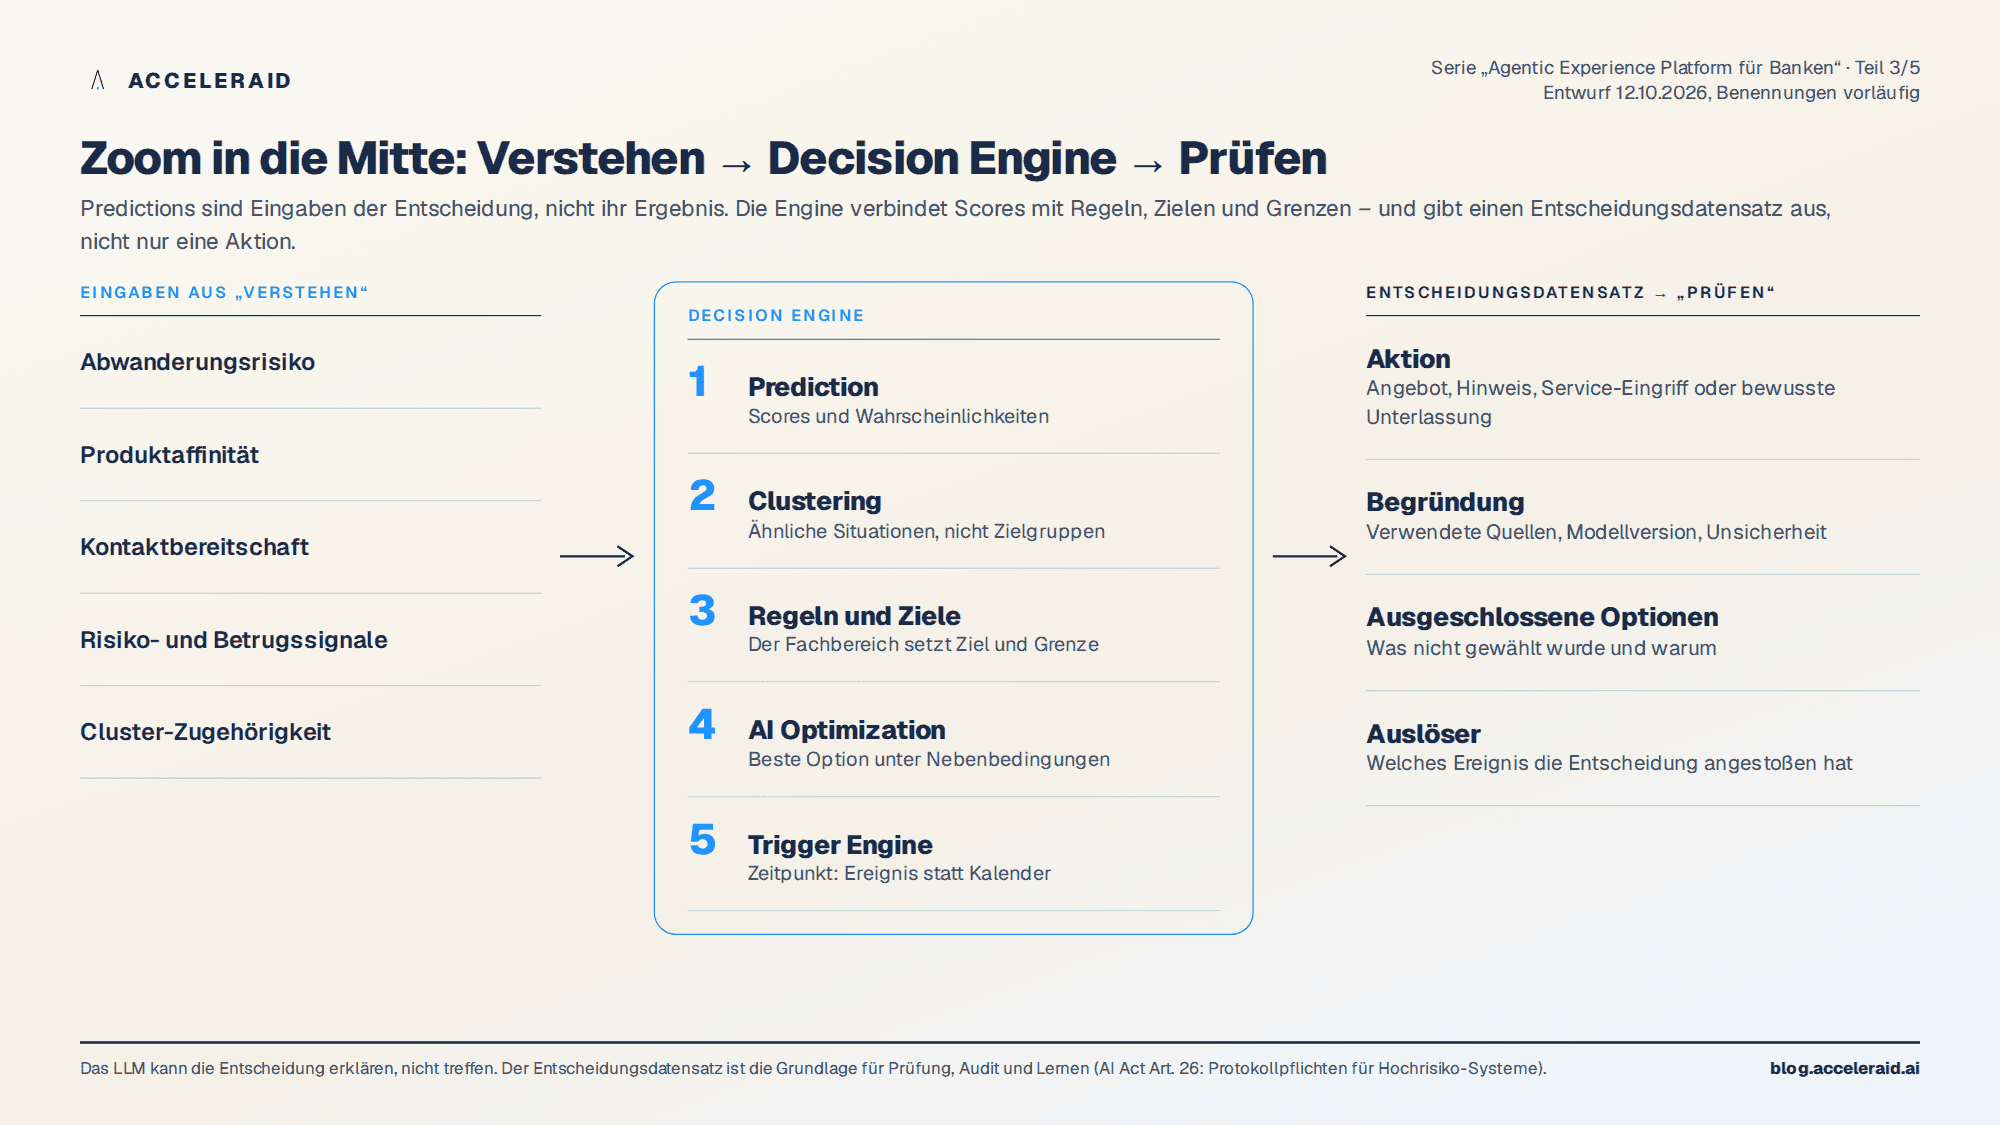
Die Engine selbst verbindet fünf Bausteine. Prediction liefert Scores und Wahrscheinlichkeiten. Clustering ordnet den Fall ähnlichen Situationen zu, nicht Zielgruppen; der Unterschied ist, dass eine Situation vorübergeht und eine Zielgruppe bleibt. Regeln und Ziele kommen aus dem Betriebsmodell, das Teil 1 beschrieben hat: Der Fachbereich setzt Ziel und Grenze. AI Optimization wählt unter den zulässigen Optionen die beste aus, gemessen an der Zielfunktion und unter Nebenbedingungen wie Kontaktbudget und Eignung. Die Trigger Engine bestimmt den Zeitpunkt: ein Ereignis, nicht ein Kalender.
Der Ausgang ist kein Befehl, sondern ein Entscheidungsdatensatz mit vier Teilen: die Aktion selbst, die auch eine bewusste Unterlassung sein kann; die Begründung mit verwendeten Quellen, Modellversion und Unsicherheit; die ausgeschlossenen Optionen mit dem Grund ihres Ausschlusses; und der Auslöser. Dieser Datensatz geht an den Schritt Prüfen. Er ist zugleich das, was ein Prüfer später liest.
Am Beispiel aus Teil 2 wird das greifbar, hypothetisch wie dort: Der Gehaltseingang einer Kundin bleibt aus. Die Prognosen melden ein mittleres Abwanderungsrisiko, eine hohe Affinität zu einem Ratenkredit und eine geringe Kontaktbereitschaft, weil vor drei Wochen ein Servicefall lief. Die Regeln schließen das Kreditangebot aus, weil ein Werbewiderspruch vorliegt und die Eignung ungeprüft ist. Die Optimierung wählt unter den verbleibenden Optionen, bewusste Stille oder Hinweis über die Beraterin, den Hinweis, weil der erwartete Kundenwert bei einer möglichen Notlage höher ist als das Risiko einer unerwünschten Ansprache. Der Auslöser ist das Ereignis, nicht ein Selektionslauf. Im Entscheidungsdatensatz steht das Kreditangebot als ausgeschlossene Option mit Grund, und genau dieser Eintrag ist es, der später zeigt, dass die Engine die Regel angewendet hat und nicht nur zufällig richtig lag.
Warum der Entscheidungsdatensatz keine Kür ist
Für einen Teil der Entscheidungen ist dieser Datensatz gesetzlich vorgeschrieben. Die KI-Verordnung stuft Systeme zur Bewertung der Kreditwürdigkeit natürlicher Personen und zur Bonitätsbewertung als Hochrisiko-Anwendungen ein (EU AI Act, Anhang III). Für Betreiber solcher Systeme gelten Pflichten zur menschlichen Aufsicht, zur Überwachung des Betriebs und zur Aufbewahrung der automatisch erzeugten Protokolle (EU AI Act, Artikel 26). Eine Entscheidungsschicht, die diese Protokolle erst nachträglich aus Logdateien rekonstruiert, erfüllt den Zweck nicht; sie muss den Datensatz im Moment der Entscheidung erzeugen.
Für alle anderen Entscheidungen, also für den weit größeren Teil von Hinweisen, Angeboten und Unterlassungen, ist derselbe Datensatz die Voraussetzung dafür, dass der Kreislauf lernen kann. Ohne die ausgeschlossenen Optionen weiß niemand, ob die Engine richtig lag oder nur Glück hatte. Ohne die Modellversion lässt sich eine Verschlechterung nicht zuordnen. Ohne den Auslöser bleibt unklar, ob der Zeitpunkt oder der Inhalt die Reaktion bestimmt hat.
Vier Entscheidungsarten, vier Prüfschärfen
Nicht jede Entscheidung braucht dieselbe Kontrolle. Wir unterscheiden vier Arten, geordnet nach dem Risiko für die Kundin, nicht nach dem Aufwand für die Bank. Die Einstufung ist ein Vorschlag für die Diskussion mit Fachbereich und Compliance; die Beispiele sind hypothetisch.
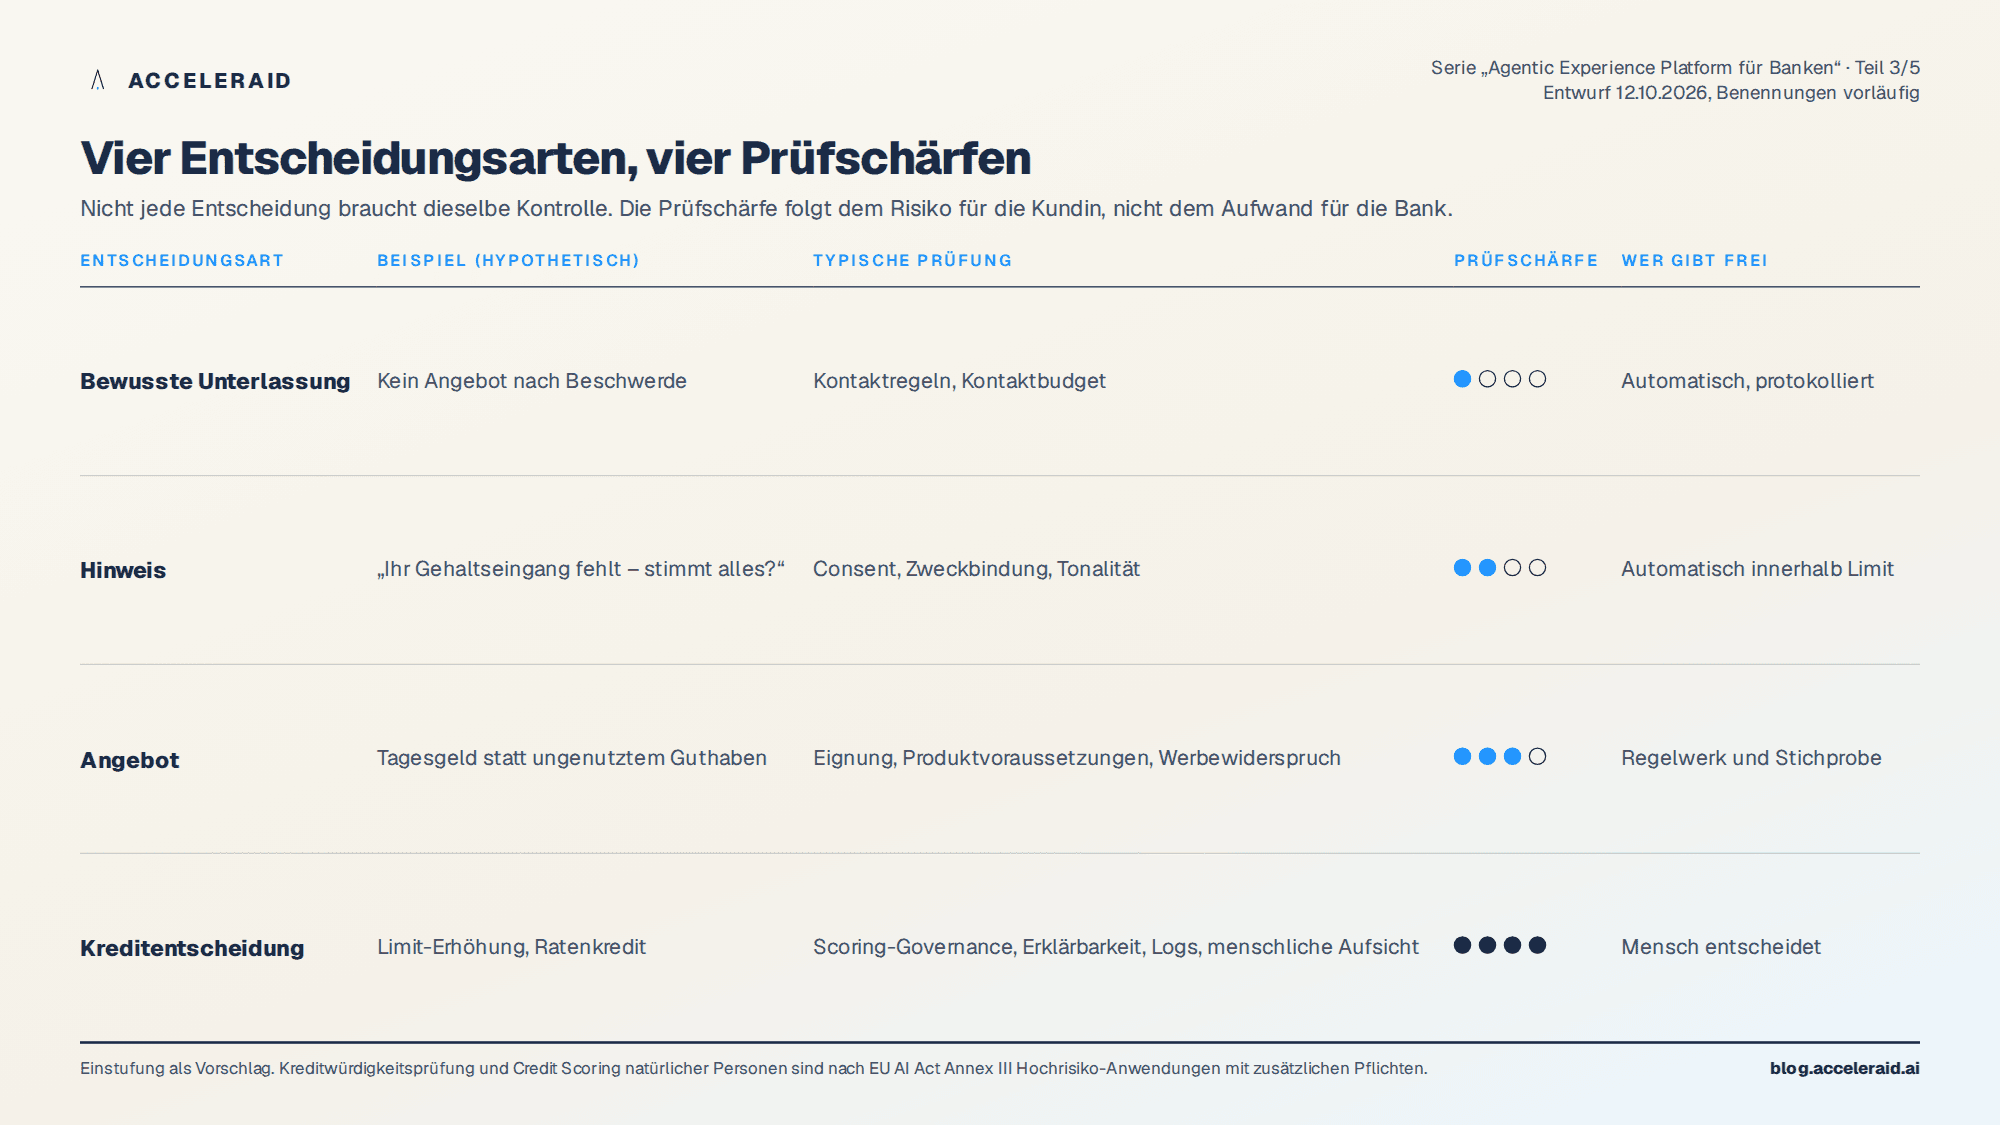
Die bewusste Unterlassung ist die häufigste Entscheidung und die am wenigsten beachtete: kein Angebot nach einer Beschwerde, keine Ansprache, wenn das Kontaktbudget verbraucht ist. Sie wird automatisch getroffen und protokolliert. Der Hinweis informiert, ohne zu verkaufen: Der Gehaltseingang fehlt, stimmt alles? Hier prüft die Engine Einwilligung, Zweckbindung und Tonalität und handelt innerhalb eines Limits automatisch. Das Angebot verlangt Eignung, Produktvoraussetzungen und die Beachtung eines Werbewiderspruchs; es läuft nach Regelwerk mit Stichprobenkontrolle. Die Kreditentscheidung schließlich bleibt beim Menschen; die Engine bereitet vor, erklärt und dokumentiert, entscheidet aber nicht.
Diese Abstufung entspricht auch dem, was Kunden akzeptieren. In der aktuellen Salesforce-Befragung sind 38 Prozent der Kunden damit einverstanden, dass ein Agent personalisierte Inhalte erstellt, aber nur 17 Prozent damit, dass er finanzielle Entscheidungen für sie trifft (Salesforce). Eine Entscheidungsschicht, die diese Grenze nicht eingebaut hat, verliert Vertrauen schneller, als sie Effizienz gewinnt.
Die Rolle des Sprachmodells
Es ist auffällig, dass in der Beschreibung der Engine bisher kein Sprachmodell vorkam. Das ist Absicht. Scores kommen aus statistischen Modellen, die auf den Daten der Bank trainiert sind und deren Verhalten sich messen lässt. Regeln kommen aus dem Fachbereich. Die Optimierung ist Mathematik unter Nebenbedingungen. Das Sprachmodell hat in dieser Schicht zwei Aufgaben, und beide liegen am Rand: Es kann die Begründung eines Entscheidungsdatensatzes in verständliche Sprache übersetzen, für die Beraterin ebenso wie für den Prüfer, und es kann unstrukturierte Signale wie eine Servicenotiz in strukturierte Merkmale verwandeln, die dann wie jede andere Eingabe behandelt werden.
Was das Sprachmodell nicht tun sollte, ist die Entscheidung selbst zu treffen. Nicht, weil es dazu nicht in der Lage wäre, sondern weil sich seine Entscheidung nicht so prüfen, versionieren und reproduzieren lässt wie die einer Regel oder eines Scores. Gartner erwartet, dass bis 2028 mindestens 15 Prozent der täglichen Arbeitsentscheidungen autonom von agentischer KI getroffen werden (Gartner). In einer Bank wird dieser Anteil nur dann vertretbar, wenn jede dieser Entscheidungen auf einem Datensatz beruht, den ein Mensch nachlesen kann. Wir haben die Architektur dafür in der Customer-Brain-Roadmap beschrieben.
Was im nächsten Teil folgt
Ein geprüfter Entscheidungsdatensatz ist noch keine Erfahrung für die Kundin. Er muss im Kanal ankommen, in der App, auf dem Berater-Arbeitsplatz, im Service, und das Ergebnis muss zurückfließen. Teil 4 behandelt Personalisierung als Aktivierungsschicht.
Fünf Punkte zum Mitnehmen
Prognosen sind Eingaben der Entscheidung, nicht ihr Ergebnis; zwischen Score und Handlung liegen Regeln, Ziele, Grenzen und ein Entscheidungsdatensatz.
Der Entscheidungsdatensatz enthält Aktion, Begründung, ausgeschlossene Optionen und Auslöser; für Hochrisiko-Anwendungen ist er Pflicht, für alle anderen die Voraussetzung des Lernens.
Vier Entscheidungsarten brauchen vier Prüfschärfen: Unterlassung und Hinweis laufen automatisch, Angebote nach Regelwerk, Kreditentscheidungen beim Menschen.
Kunden ziehen dieselbe Grenze: Inhalte dürfen Agenten erstellen, finanzielle Entscheidungen nur eine kleine Minderheit.
Das Sprachmodell erklärt und strukturiert; es entscheidet nicht, weil seine Entscheidung nicht so prüfbar und reproduzierbar ist wie Regel und Score.
Illustration: KI-generiert. KI-gestützte Inhalte: Bei der Erstellung unserer Beiträge setzen wir KI-Technologien und automatisierte Agenten ein, unter anderem von Microsoft, Google, OpenAI, Anthropic und weiteren Anbietern. Themen, fachliche Ausrichtung und finale Freigabe liegen bei unserem Team.
Weiterlesen
Weitere Artikel

KI & Banking
Agentic Experience Platform für Banken: Warum der Kreislauf zählt, nicht das Werkzeug
Treasure AI, Golden Context, 15 CDP-Anwendungsfälle: Warum in Banken die Zeit vom Signal zur geprüften Handlung zählt, nicht das Werkzeug. Serienauftakt.

CLM & CVM
Customer Lifecycle Management und Customer Value Management: Das Betriebsmodell für Agenten
Teil 1/5: CLM liefert die Zeilen, CVM die Zielfunktion. Warum Agenten ohne Betriebsmodell auf Klicks optimieren und was in jede Zelle der Matrix gehört.

Daten & Technologie
Customer Data Platform mit Kontext-Layer: Vom Golden Record zum Golden Context
Teil 2/5: Drei Kontexte, fünf Funktionen, vier Arten von Gedächtnis. Was aus einem Datenfeld ein Kontextobjekt macht und was der Agent nicht sehen soll.
