Daten & Technologie
Kosten der KI-Inferenz: Warum Banken trotz billigerer Modelle mehr zahlen und was hilft
Die Kosten der KI-Inferenz steigen in Banken, obwohl Token billiger werden. Routing, kleine Modelle und Rechenzentren nahe an den Daten senken sie.
•
acceleraid Redaktion
•
9 Min.
Die Preise für KI-Modelle fallen seit drei Jahren schneller als fast jede andere Technologiekennzahl. Trotzdem steigt in vielen Banken die Rechnung für KI im Kundengeschäft. Der Grund liegt in der Inferenz, also im laufenden Betrieb: Jede Antwort eines Assistenten, jede Zusammenfassung eines Beratungsgesprächs und jeder Schritt eines KI-Agenten verbraucht Rechenleistung. Dieser Beitrag erklärt, warum die Kosten der KI-Inferenz für Banken steigen, obwohl einzelne Token billiger werden, was sich bei Chips und Rechenzentren verschiebt und welche Architektur die Kosten je Kundengespräch steuerbar macht, ohne Kundendaten aus der Hand zu geben.
Warum die Kosten der KI-Inferenz steigen, obwohl Token billiger werden
Der Preis je Leistungseinheit sinkt stark, aber die Menge wächst schneller, vor allem durch KI-Agenten. Epoch AI hat die Preise von Sprachmodellen seit 2023 ausgewertet: Die Kosten, um ein bestimmtes Leistungsniveau zu erreichen, fallen im Mittel um rund 47 Prozent pro Quartal, das entspricht etwa einem Faktor 13 pro Jahr (Epoch AI, September 2026). Epoch weist selbst auf eine Einschränkung hin: Die Rechnung unterstellt, dass Nutzer immer zum günstigsten Modell mit dieser Leistung wechseln. In der Praxis sparen Unternehmen deshalb weniger.
Auf der anderen Seite steht die Menge. Gartner erwartet, dass die Inferenzkosten je agentischem Arbeitsablauf bis 2028 auf mehr als das Fünffache steigen. Ein agentisches Modell mit Denkschritten kostet mindestens fünfmal so viel wie eine einfache Chatbot-Interaktion, und Agenten benötigen je Aufgabe fünf- bis dreißigmal mehr Token (VentureBeat zu Gartner, Oktober 2026). Gartner nennt das ein „Inference Paradox“: Der Stückpreis fällt, die Rechnung wächst.
Auch auf Ebene der gesamten Rechenleistung verschiebt sich das Gewicht. Deloitte schätzt, dass Inferenz 2026 rund zwei Drittel aller KI-Rechenleistung ausmacht, nach etwa einem Drittel 2023 und der Hälfte 2025 (Deloitte TMT Predictions 2026). Für eine Bank heißt das: Die relevante Größe ist nicht mehr der Preis je Million Token, sondern der Preis je erledigtem Anliegen.

Eine hypothetische Sparkasse sortiert ihre KI-Anfragen
Illustration: KI-generiert, hypothetisches Beispiel.
Hypothetisches Beispiel: Die IT-Leiterin einer mittelgroßen Sparkasse bekommt die Hochrechnung für das kommende Jahr. Der KI-Assistent im Kundenservice soll von der Pilotgruppe auf alle Beraterinnen und Berater ausgerollt werden, dazu ein Agent, der Kontoanfragen vorbereitet. Wenn jede Anfrage wie im Pilot an ein großes Cloud-Modell geht, würde sich die Rechnung vervielfachen. Gemeinsam mit ihrem Architekten geht sie zwei Wochen lang die Anfragen der Pilotphase durch. Das Ergebnis: Ein großer Teil sind Routinefälle wie Fragen zu Kartensperre, Daueraufträgen oder Kontoauszügen. Dafür reicht ein kleines Modell im eigenen oder regionalen Rechenzentrum, das auch die personenbezogenen Daten nicht verlässt. Nur komplexe Fälle ohne direkten Personenbezug sollen weiter an ein großes Modell gehen. Die Sparkasse und die Personen sind frei erfunden.
Die Entscheidung der beiden ist keine Sparmaßnahme gegen KI. Sie ist eine Architekturentscheidung: Welche Anfrage braucht welches Modell, an welchem Ort und mit welchen Daten?
Was große Banken heute tun: Routing und kleinere Modelle
Die Banken, die KI am weitesten skaliert haben, bauen gezielt eine Weiche vor die Modelle. Bank of America leitet Anfragen über eine eigene Routing-Schicht namens „Orchestra“. Ein kleines Klassifikationsmodell entscheidet, welches Modell eine Anfrage am kostengünstigsten bearbeitet. CTO und CIO Hari Gopalkrishnan sagte im Oktober 2026, man wolle von keinem einzelnen Modell abhängig sein, und für viele einfache Entscheidungen brauche man kein großes Sprachmodell (CIO Dive, Oktober 2026).
Capital One geht denselben Weg mit destillierten, kleineren Modellen für seinen Chat Concierge. Laut Prem Natarajan sank die Antwortzeit damit um den Faktor fünf, und die Interaktion mit Autohändlern stieg um 50 Prozent (ebenfalls CIO Dive). Kleinere Modelle sind also nicht nur günstiger, sondern oft auch schneller, was im Kundengespräch zählt.
BNP Paribas betreibt eine eigene LLM-as-a-Service-Plattform in den eigenen Rechenzentren mit Open-Source- und Mistral-Modellen (BNP Paribas) und hat die Partnerschaft mit Mistral im Mai 2026 unter anderem für KYC-Anwendungen im eigenen Haus verlängert (BNP Paribas, Mai 2026). Auch nach einem neuen Cloud-Vertrag mit Google bleibt die eigene Infrastruktur bestehen. CIO Marc Camus betonte, der Vertrag bedeute nicht, dass man die On-Premise-Infrastruktur aufgebe; hochvertrauliche Daten bleiben außerhalb der Public Cloud, Modell und Infrastruktur werden je Anwendung gewählt (Mobile World Live, September 2026).
Breit angekommen ist das noch nicht. In einer VentureBeat-Umfrage unter 109 Unternehmen leiten nur 31 Prozent Routineaufgaben gezielt an günstigere Modelle, und 21 Prozent haben keinen automatischen Stopp, wenn Agenten zu viele Token verbrauchen (VentureBeat, Oktober 2026). Wie man Modelle grundsätzlich nach Aufgabe auswählt, beschreibt unser Beitrag KI-Modellkosten: Welches Modell wofür.
Mehr Auswahl bei den Chips, aber nicht überall frei verfügbar
Für Inferenz gibt es inzwischen echte Alternativen zu Nvidia, und das verändert die Verhandlungsposition von Banken und ihren Rechenzentrumspartnern. Nach Schätzungen von Silicon Analysts hielt Nvidia 2025 im Training mehr als 90 Prozent des Marktes, in der Inferenz nur noch 60 bis 75 Prozent (Quartz, Juli 2026). Inferenz stellt andere Anforderungen als Training: Es zählen Energie, Speicher und Kosten je Antwort, weniger die maximale Rechenleistung im Verbund.
Drei Entwicklungen sind für Banken relevant. AMD hat auf der CES 2026 mit dem MI440X einen Beschleuniger für Inferenz im eigenen Rechenzentrum vorgestellt (Computerworld, Januar 2026). Google bezeichnet seine TPU „Ironwood“ als erste TPU, die eigens für Inferenz entwickelt wurde; sie ist allerdings nur als Mietleistung in Google Cloud erhältlich (Quartz). Intel hat mit der GPU-D-Serie „Crescent Island“ eine luftgekühlte Inferenz-GPU mit bis zu 480 GB Speicher und 350 Watt angekündigt, die in bestehende Rechenzentren passt (Intel, Oktober 2026); Muster sind verfügbar, der Marktstart wird für 2027 erwartet (ServeTheHome).
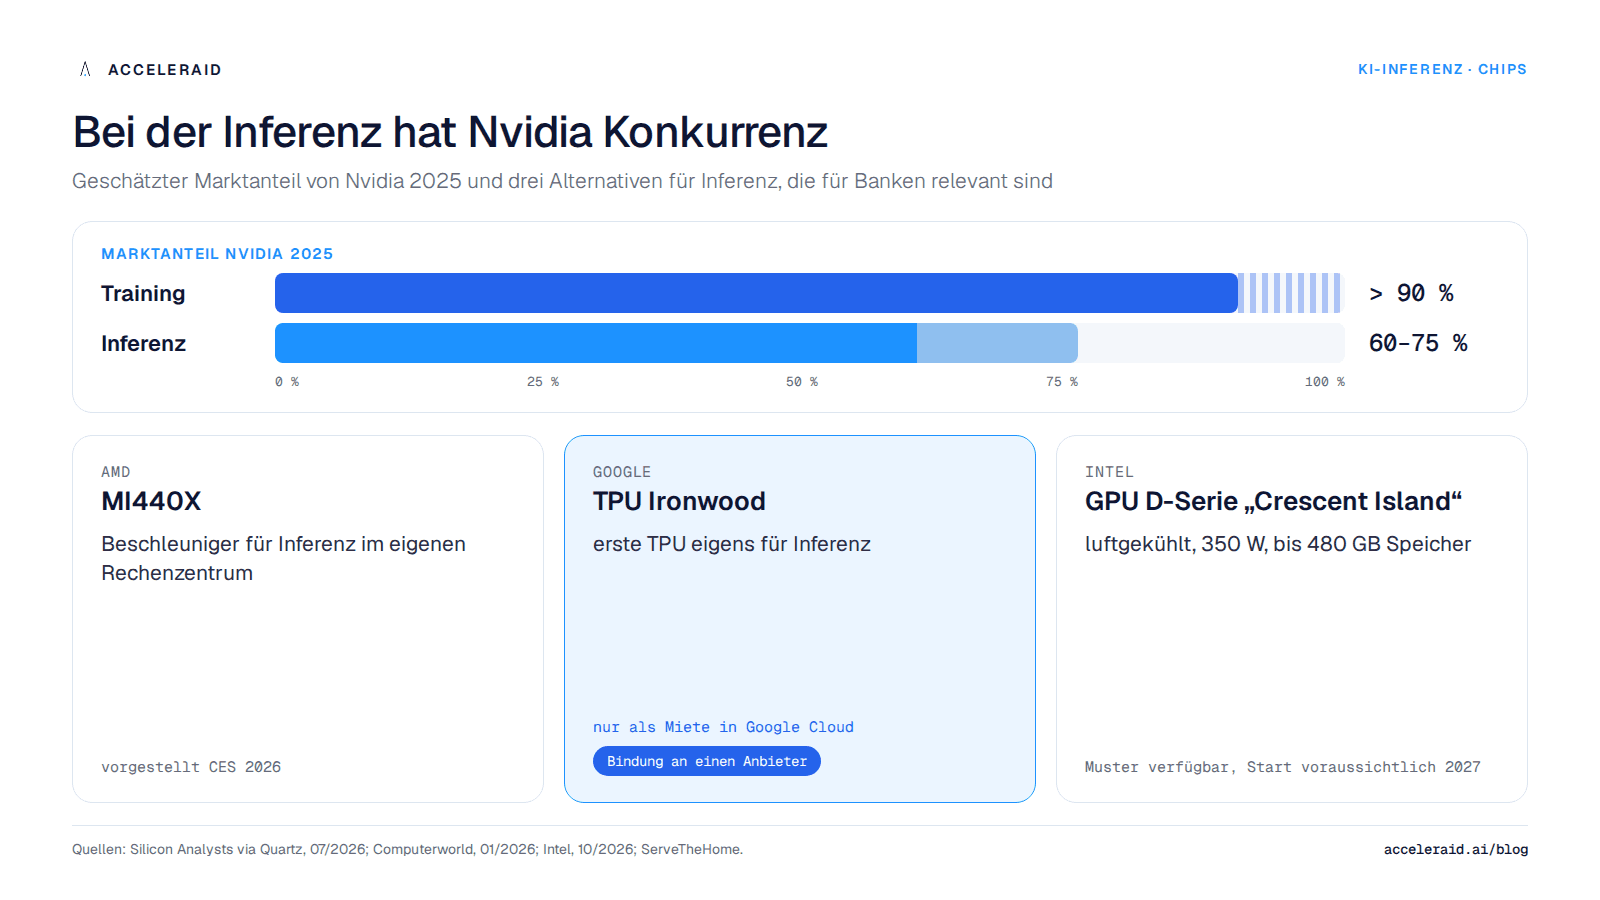
Für die Architektur einer Bank folgt daraus: Mehr Wettbewerb kann die Kosten je Antwort senken. Manche Alternativen binden aber an einen einzigen Cloud-Anbieter. Das ist unter DORA ein Konzentrationsrisiko, das dokumentiert und mit einer Exit-Option hinterlegt werden muss, wie unser Beitrag zum Konzentrationsrisiko bei KI-Anbietern zeigt.
Lokal, im eigenen Rechenzentrum oder in der Cloud?
Für Banken ist die eigentliche Wahl nicht „Laptop oder Cloud“, sondern „eigenes oder regionales Rechenzentrum oder Public Cloud“. Deloitte erwartet, dass 2026 fast die gesamte KI-Rechenleistung in Rechenzentren und Unternehmensservern läuft, nicht auf PCs oder Smartphones; die KI-Chips in Endgeräten übernehmen vor allem einfache Einzelaufgaben (Deloitte). Gleichzeitig wächst der Markt für KI-Systeme im eigenen Rechenzentrum laut Deloitte 2026 auf mehr als 50 Milliarden US-Dollar. Ein Server mit acht GPUs kostet 300.000 bis 500.000 US-Dollar, ein ganzes Rack drei bis fünf Millionen.
Wann sich das rechnet, beschreibt Lenovo-Manager Arthur Hu sinngemäß so: Wer Größe und Planbarkeit seiner Last kennt, muss den Aufpreis der flexiblen Cloud nicht zahlen. Datenschutz und Souveränität nennt er als zusätzliche Treiber (Computerworld). Genau das trifft auf viele Bankanwendungen zu: Servicefragen, Gesprächszusammenfassungen und Klassifikationen sind gut planbar und enthalten personenbezogene Daten.
Ganz ohne Engpass ist auch der lokale Weg nicht. Apple-Chef Tim Cook sprach im Mai 2026 von monatelangen Lieferengpässen bei Mac mini und Mac Studio, getrieben auch durch Nachfrage nach lokaler KI; zugleich ist Speicher knapp, weil dieselben Hersteller den Bedarf der Rechenzentren bedienen (Tom's Hardware, Mai 2026). Wer eigene Hardware plant, sollte Lieferzeiten einkalkulieren. Was der Weg bis zum Produktivbetrieb kostet, zeigt unser Beitrag zum Self-Hosting von LLMs.
Blase oder Umbau? Drei Szenarien statt einer Prognose
Ob die Investitionen in KI-Rechenzentren eine Blase sind, kann heute niemand belastbar sagen. Für Banken ist wichtiger, dass ihre Architektur in mehreren Szenarien funktioniert. Drei Entwicklungen sind plausibel:
Der Preisverfall setzt sich durch. Mehr Wettbewerb bei Chips und Modellen senkt die Kosten je Antwort schneller, als die Menge wächst. Dann gewinnt, wer schnell zwischen Modellen wechseln kann.
Die Menge wächst schneller. Agenten mit vielen Denkschritten treiben den Verbrauch, wie Gartner es erwartet. Dann gewinnt, wer Routinefälle konsequent an kleine Modelle gibt und Budgets je Agent setzt.
Knappheit verteuert zeitweise. Speicher, Strom oder Chips werden zum Engpass, und Anbieter erhöhen Preise oder Kontingente. Dann gewinnt, wer einen Teil der Last planbar im eigenen oder regionalen Rechenzentrum betreibt.
Die Antwort ist in allen drei Fällen dieselbe: eine Weiche vor den Modellen, gemessene Kosten je Anliegen und eine Exit-Option. Wie sich der tatsächliche Nutzen dagegen messen lässt, haben wir im Beitrag KI-Blase oder echter Nutzen? beschrieben.
So steuern Banken die Kosten je Kundengespräch
Die Kosten der KI-Inferenz werden steuerbar, wenn jede Anfrage einen Weg, ein Budget und einen Messpunkt hat. Gartner empfiehlt dafür unter anderem Beobachtbarkeit der Kosten, eine Bewertung nach Wert je Ergebnis, eine Staffelung der Modelle mit Routing und Stresstests gegen schwankende Tokenpreise (VentureBeat zu Gartner). Für eine Bank lässt sich das in fünf Schritte übersetzen:
Kosten je Anliegen messen: nicht je Token, sondern je gelöster Kundenfrage, je Gesprächszusammenfassung, je Agentenaufgabe.
Anfragen nach Schwierigkeit und Datenart sortieren: Routine mit Personenbezug an kleine Modelle im eigenen oder regionalen Rechenzentrum, komplexe Fälle ohne Personenbezug oder pseudonymisiert an große Modelle.
Budgets und Stopps je Agent setzen: eine Obergrenze für Token und Schritte, danach Übergabe an einen Menschen.
Kontext klein halten: Ein Agent bekommt nur die Daten, die er für die Aufgabe braucht. Das senkt Token und erfüllt zugleich das Prinzip der Datenminimierung der DSGVO.
Wechsel vorbereiten: Modelle über eine einheitliche Schnittstelle anbinden, damit ein Austausch keine neue Integration erfordert.
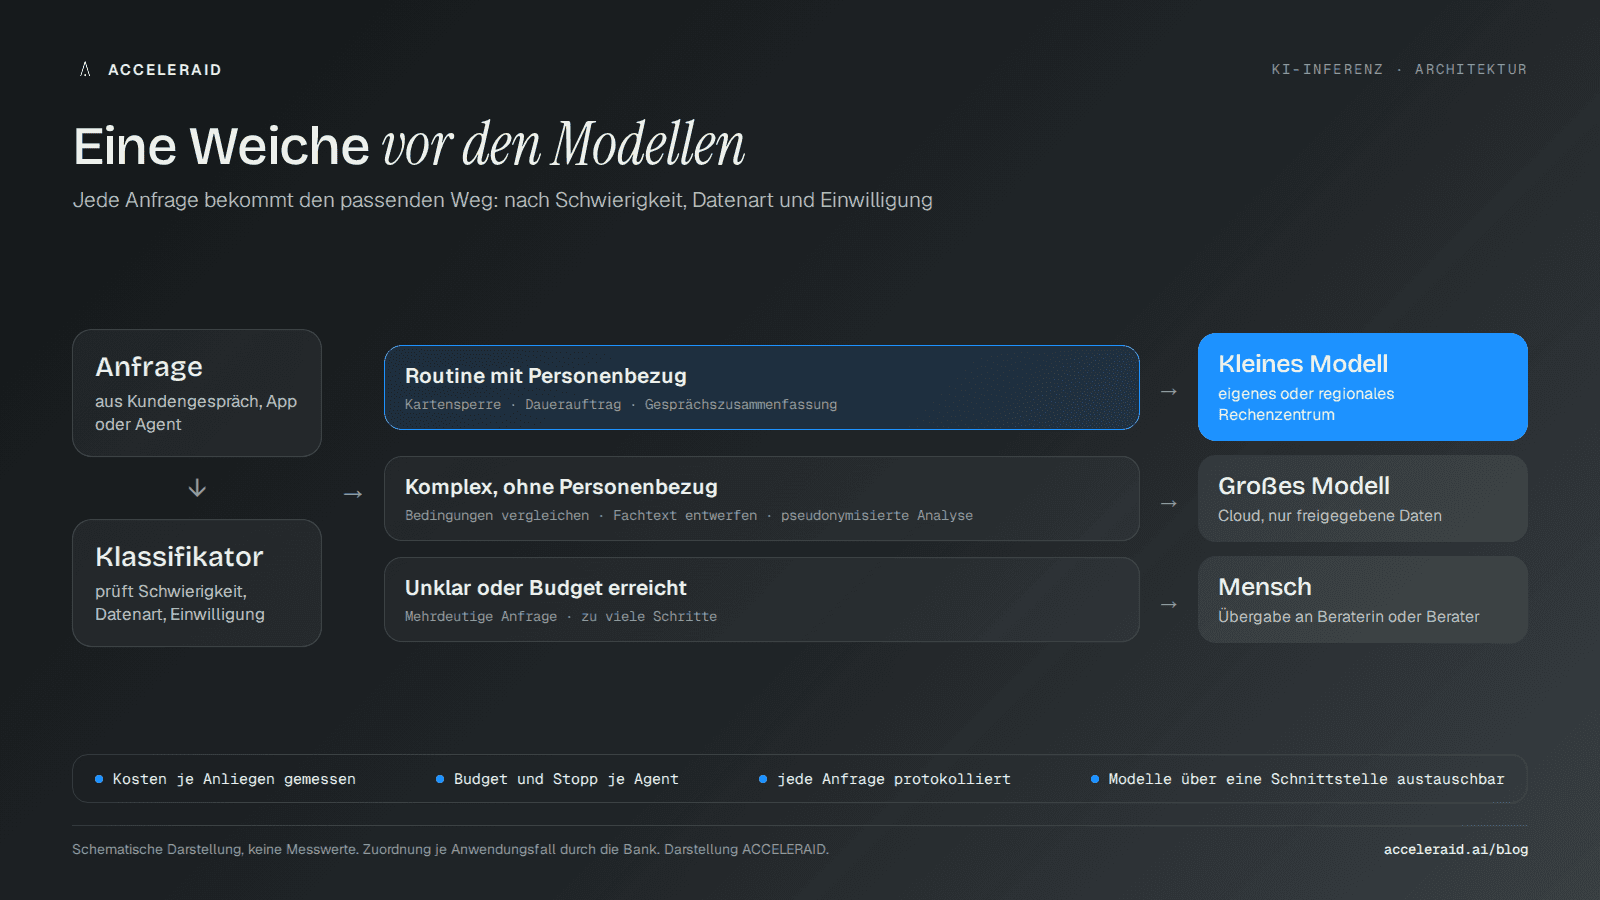
Wie eine solche Weiche mit Planer, Fachagenten und Prüfer zusammenspielt, beschreibt unser Beitrag zum Orchestration Layer in Banken.
Datenschutz ist der zweite Grund für Inferenz nahe an den Daten
Für Banken ist die Frage, wo ein Modell rechnet, nicht nur eine Kostenfrage, sondern eine Frage von Datenschutz und Aufsicht. Je mehr personenbezogene Daten ein Assistent verarbeitet, desto wichtiger wird, dass sie das eigene Haus oder den vertraglich gebundenen Rechenzentrumspartner nicht verlassen. ACCELERAID setzt deshalb auf DSGVO by Design: Die Plattform läuft als Private Cloud in einem ISO-27001-zertifizierten Rechenzentrum in Frankfurt, auf Anfrage auch On-Premise bei der Bank, und ist nach SOC 2 Type I zertifiziert (ACCELERAID). Es gibt kein mandantenübergreifendes Training, die Daten einer Bank trainieren nur ihre eigenen Modelle. Der AI Context Layer prüft vor jeder Anfrage an ein Modell Einwilligung und Zweck und gibt nur den Kontext weiter, den die Aufgabe braucht; die übergreifende Orchestrierungs- und Steuerungsebene befindet sich derzeit in Entwicklung. Weniger Kontext bedeutet dabei auch weniger Token, Datenschutz und Kostensteuerung zeigen hier in dieselbe Richtung.
Fünf Punkte zum Mitnehmen
Die Kosten der KI-Inferenz steigen in Banken, obwohl Token billiger werden: Epoch AI misst einen Preisverfall von etwa Faktor 13 pro Jahr je Leistungsniveau, Gartner erwartet mehr als fünfmal höhere Kosten je agentischem Arbeitsablauf bis 2028.
Inferenz macht laut Deloitte 2026 rund zwei Drittel der KI-Rechenleistung aus; die entscheidende Größe für Banken sind die Kosten je gelöstem Anliegen.
Bank of America, Capital One und BNP Paribas zeigen den Weg: Routing vor den Modellen, kleinere Modelle für Routine und Infrastruktur je Anwendung.
Bei Chips wächst die Auswahl, doch manche Alternativen sind nur bei einem Cloud-Anbieter verfügbar; das ist unter DORA ein Konzentrationsrisiko.
Inferenz nahe an den Daten senkt in planbaren Anwendungen die Kosten und schützt personenbezogene Daten; Budgets je Agent, kleiner Kontext und eine Exit-Option machen die Architektur robust in jedem Szenario.
Illustration: KI-generiert. KI-gestützte Inhalte: Bei der Erstellung unserer Beiträge setzen wir KI-Technologien und automatisierte Agenten ein, unter anderem von Microsoft, Google, OpenAI, Anthropic und weiteren Anbietern. Themen, fachliche Ausrichtung und finale Freigabe liegen bei unserem Team.
Weiterlesen
Wie es weitergeht.
Aus dem Blog

Daten & Technologie
Kontext-Layer im Banking: Warum Kundenkontext Tempo, Zweckbindung und ein Verfallsdatum braucht

Daten & Technologie
Mastercard AN4569 und Visas Enhanced Merchant Data: Wenn die Bank jede Transaktion erklären muss

Daten & Technologie